Transformer
一文读懂Transformer架构与多头自注意力机制。
本文参考此书 bishop,这篇文章 Ketan Doshi,还有这篇文章 jalammar,以及原版论文 Vaswani et al(2017)。
transformers are based on a processing concept called attention, which allows a network to give different weights to different inputs, with weighting coefficients that themselves depend on the input values, thereby capturing powerful inductive biases related to sequential or other form of data.
I took the above from the book DLFC.
weights 代表着重要性,自然语言中同一条语句的不同词之间相互有不同的重要性。transformer中不同神经元的 connection strength (the weighting coefficients)是动态的。
而在MLP中前向传播时的 weights 是固定的:。同样的,在CNN中conv filter也是固定的:
我们发现以往的架构在前向传播总是用fixed connection numbers与输入进行线性组合。
transformer 在NLP任务上打败了传统的RNN,以及后续的变体LSTM, GRU,以及RNN + Attention(作为外挂),并且还有尝试用CNN完成序列建模(ByteNet、ConvS2S)。
Vaswani et al. (2017) 之后vision transformer,multi modal transformer也陆续上线。
transformer 厉害的原因,一是处理信息的效率高,二是顺应GPU并行计算,三是自监督学习方法可以容下大量训练数据,四是scaling law在此架构上依旧有效。
transformer中是由多个transformer blocks函数组成的,它的输入和输出的矩阵保持着相同的维度(T, D)。但在实践中,我们会加上batch,也就是(B, T, D)。
每个transformer block有着它自己的weights and biases。多个transformer按顺序连在一起,就形成了深度学习网络。
总的来讲,一个transformer block主要有两个用于学习的网络:Causal Multi-head self attetion(CMHA), Feed-forward network(FFN)
attention
我们都见过这个著名的自注意力公式:
Attention的最终分数,由Q矩阵与K矩阵的转置的点积,除以一个缩放系数sqrt(d_k),经softmax后再与V矩阵做点积。
这其实很简单,我们现忽略softmax和缩放系数,因为他们只是为了numerical stability,与核心无关。一个电影有许多不同的attributes,比如genere,leading actors等等,这些attributes就有点像是被编码的,而电影内容就是。设想我们把想看的电影内容所应该具有的attributes设为,我们就拿着对着所有的去找最佳匹配的一项。
其中的Q, K, V是输入X经由, , 矩阵的线性组合得来的:
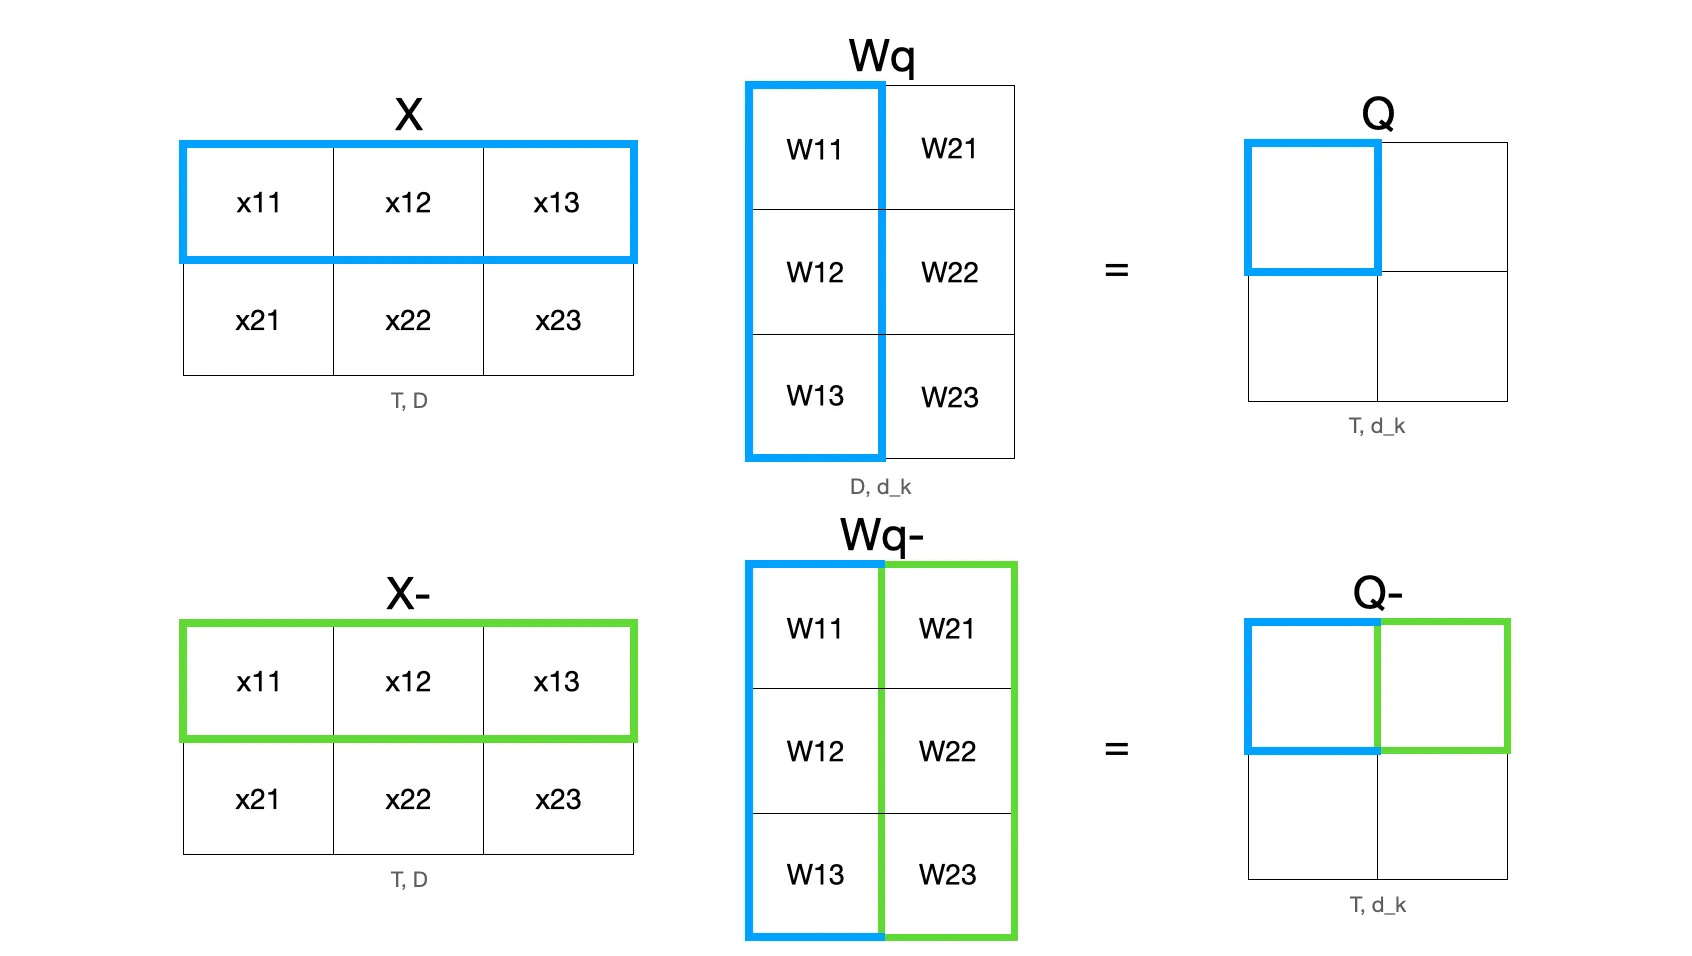
上图描绘的是一个emb vector 与 矩阵的线性组合过程,Q, K, V 的矩阵的每一行都对应着X的相同行的token经由线性变换后的值。
我们先看一下attention scores(before softmax):
仔细看一下Q和K的点积,the score between query and key is:
Then attention weights:
And the output for query :