由于Transformer的自注意力机制具有置换不变形(Permutation Invariance)。也就是说即使输入词序列即使被打乱,自注意力的计算结果也完全一致。我们没有recurrence 和 convolution
因而我们需要引入位置信息。
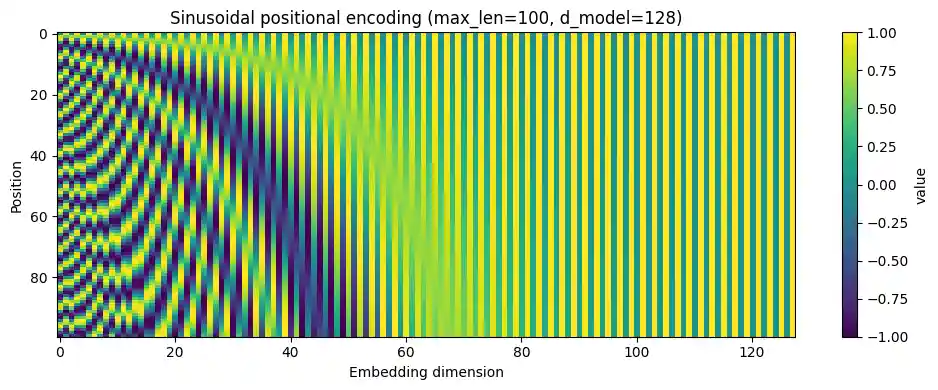
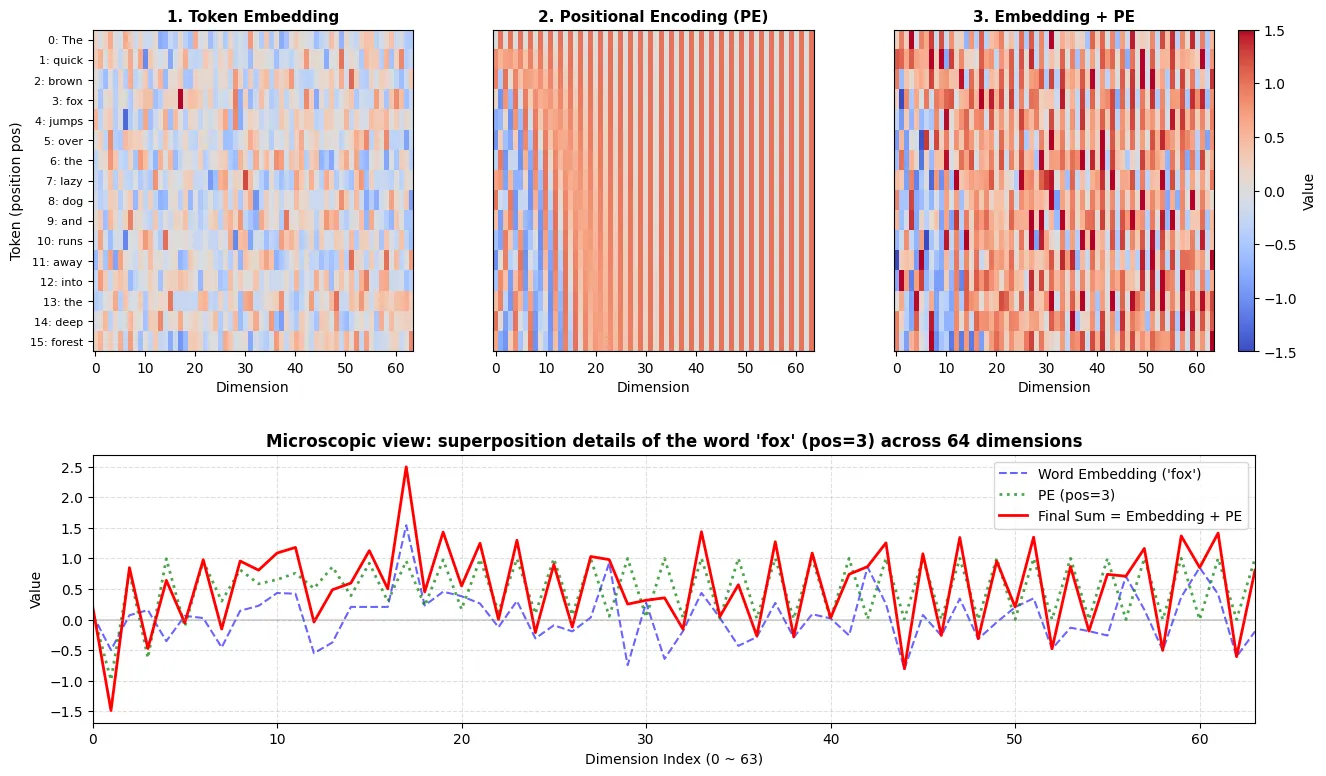
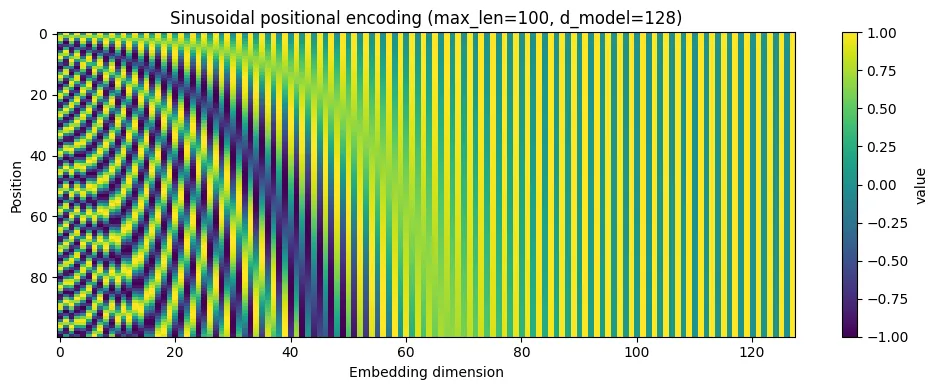
图1. token embedding矩阵行代表着16个token,列代表着60个特征值。图2. sinusoidal encoding沿着词向量维度的轴,不同token之间的变换频率越来越高。图3. 是位置编码后的输出。
Sinusoidal PE
在 Vaswani et al. (2017) 中,作者使用了 Sinusoidal Positional ecoding:
P E ( p o s , 2 i ) = sin ( p o s 10000 2 i / d ) , P E ( p o s , 2 i + 1 ) = cos ( p o s 10000 2 i / d ) PE_{(pos, 2i)} = \sin\left(\frac{pos}{10000^{2i/d}}\right), \quad PE_{(pos, 2i+1)} = \cos\left(\frac{pos}{10000^{2i/d}}\right) P E ( p os , 2 i ) = sin ( 1000 0 2 i / d p os ) , P E ( p os , 2 i + 1 ) = cos ( 1000 0 2 i / d p os ) sin and cos
let’s review sin and cos function!
sin 和 cos 的值永远在 [-1, 1]
sin(100x) 频率高,晃动极快和 sin(0.01x) 频率低,晃动极慢
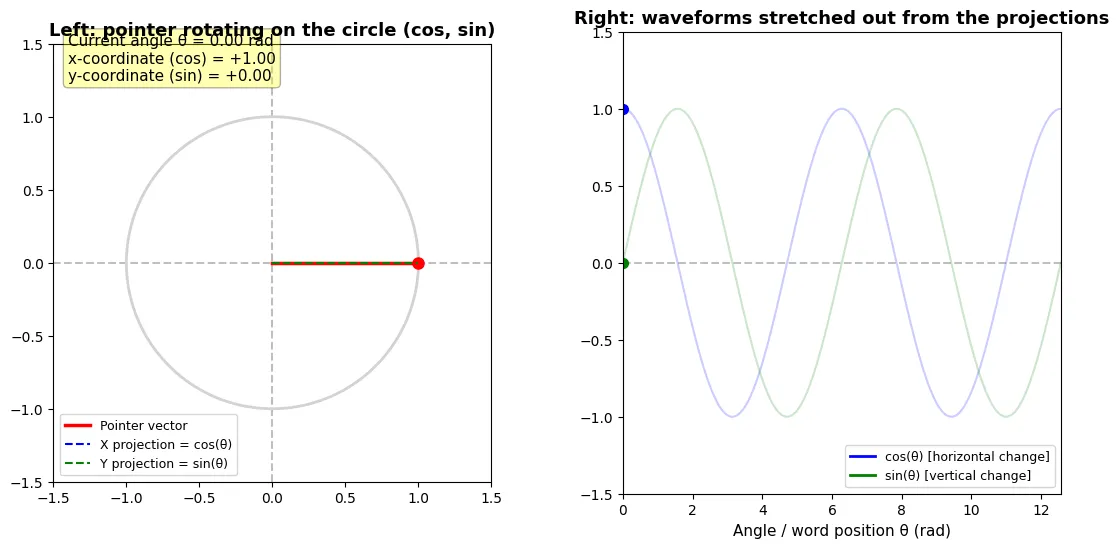
在平面直角坐标系上,如果横坐标是 cos ( θ ) \cos(\theta) cos ( θ ) sin ( θ ) \sin(\theta) sin ( θ ) θ \theta θ ( cos θ , sin θ ) ( \cos\theta, \sin\theta ) ( cos θ , sin θ ) 匀速画圈 。
sin \sin sin cos \cos cos
想象用二进制计数:
第 0 位:0, 1, 0, 1, 0, 1… (变化最快,高频)
第 1 位:0, 0, 1, 1, 0, 0… (变慢了一半)
第 2 位:0, 0, 0, 0, 1, 1… (更慢)
又像是一个钟表:
秒针 转得飞快(高频)
分针 转得中等
时针 转得最慢(低频)
现在问你:下午 3 点 15 分 42 秒 是一个独一无二的时间吗?是的,我们当然可以把这三个指针的朝向组合起来,精准且唯一地表示一天中的任何时刻。
P E ( p o s , 2 i ) = sin ( p o s ⋅ ω i ) , P E ( p o s , 2 i + 1 ) = cos ( p o s ⋅ ω i ) PE_{(pos, 2i)} = \sin(pos \cdot \omega_i), \quad PE_{(pos, 2i+1)} = \cos(pos \cdot \omega_i) P E ( p os , 2 i ) = sin ( p os ⋅ ω i ) , P E ( p os , 2 i + 1 ) = cos ( p os ⋅ ω i )
ω i = 1 10000 2 i / d \omega_i = \frac{1}{10000^{2i/d}} ω i = 1000 0 2 i / d 1
pos 就是单词的在句子里的位置索引(0, 1, 2, 3…)。
d 词向量的维度
i 当前处于哪一组维度,i ∈ [ 0 , d 2 − 1 ] i \in [0, \frac{d}{2}-1] i ∈ [ 0 , 2 d − 1 ]
整个的p向量为:
p t ⃗ = [ sin ( ω 1 t ) cos ( ω 1 t ) sin ( ω 2 t ) cos ( ω 2 t ) ⋮ sin ( ω d / 2 t ) cos ( ω d / 2 t ) ] d × 1 \vec{p_t} = \begin{bmatrix}
\sin(\omega_1 t) \\
\cos(\omega_1 t) \\
\sin(\omega_2 t) \\
\cos(\omega_2 t) \\
\vdots \\
\sin(\omega_{d/2} t) \\
\cos(\omega_{d/2} t)
\end{bmatrix}_{d \times 1} p t = sin ( ω 1 t ) cos ( ω 1 t ) sin ( ω 2 t ) cos ( ω 2 t ) ⋮ sin ( ω d /2 t ) cos ( ω d /2 t ) d × 1 随着维度 i i i ,10000 2 i / d 10000^{2i/d} 1000 0 2 i / d w w w
在低维度中,i → 0 i \to 0 i → 0 λ ≈ 2 π \lambda \approx 2\pi λ ≈ 2 π
在高维度中,i → d / 2 i \to d/2 i → d /2 λ ≈ 2 π × 10000 ≈ 62831 \lambda \approx 2\pi \times 10000 \approx 62831 λ ≈ 2 π × 10000 ≈ 62831
why?
We chose this function because we hypothesized it would allow the model to easily learn to attend by relative positions, since for any fixed offset k k k P E ( p o s + k ) PE(pos+k) P E ( p os + k ) P E ( p o s ) PE(pos) P E ( p os )
论文选择正余弦配对,最关键的数学性质在于利用三角恒等式捕获相对距离:对于固定的偏移量 k k k P E p o s + k PE_{pos+k} P E p os + k P E p o s PE_{pos} P E p os
现在我们只挑出向量里的某一小对相邻的维度(偶数维用
sin
sin
,奇数维用
cos
cos
)。
假设这一对维度的频率系数是 ω \omega ω 1 10000 2 i / d \frac{1}{10000^{2i/d}} 1000 0 2 i / d 1
在位置 p o s pos p os v p o s = [ sin ( ω ⋅ p o s ) cos ( ω ⋅ p o s ) ] v_{pos} = \begin{bmatrix} \sin(\omega \cdot pos) \\ \cos(\omega \cdot pos) \end{bmatrix} v p os = [ sin ( ω ⋅ p os ) cos ( ω ⋅ p os ) ]
现在,单词往后挪了 k k k p o s + k pos + k p os + k v p o s + k = [ sin ( ω ( p o s + k ) ) cos ( ω ( p o s + k ) ) ] v_{pos+k} = \begin{bmatrix} \sin(\omega (pos + k)) \\ \cos(\omega (pos + k)) \end{bmatrix} v p os + k = [ sin ( ω ( p os + k )) cos ( ω ( p os + k )) ]
如果把它改写成线性代数的矩阵乘法 :
[ sin ( ω ( p o s + k ) ) cos ( ω ( p o s + k ) ) ] = [ cos ( ω k ) sin ( ω k ) − sin ( ω k ) cos ( ω k ) ] [ sin ( ω ⋅ p o s ) cos ( ω ⋅ p o s ) ] \begin{bmatrix} \sin(\omega(pos + k)) \\ \cos(\omega(pos + k)) \end{bmatrix}=\begin{bmatrix}
\cos(\omega k) & \sin(\omega k) \\
-\sin(\omega k) & \cos(\omega k)
\end{bmatrix}
\begin{bmatrix} \sin(\omega \cdot pos) \\ \cos(\omega \cdot pos) \end{bmatrix} [ sin ( ω ( p os + k )) cos ( ω ( p os + k )) ] = [ cos ( ω k ) − sin ( ω k ) sin ( ω k ) cos ( ω k ) ] [ sin ( ω ⋅ p os ) cos ( ω ⋅ p os ) ] 也就是说:
v p o s + k = M k ⋅ v p o s v_{pos+k} = M_k \cdot v_{pos} v p os + k = M k ⋅ v p os
这意味着:
这里的震撼之处在哪里? 你看中间那个 2 × 2 2 \times 2 2 × 2 M k M_k M k M k = [ cos ( ω k ) sin ( ω k ) − sin ( ω k ) cos ( ω k ) ] M_k = \begin{bmatrix} \cos(\omega k) & \sin(\omega k) \\ -\sin(\omega k) & \cos(\omega k) \end{bmatrix} M k = [ cos ( ω k ) − sin ( ω k ) sin ( ω k ) cos ( ω k ) ]
这个矩阵里,只有相对距离 k k k p o s pos p os
无论你的词是在句首(p o s = 1 pos=1 p os = 1 p o s = 3 pos=3 p os = 3 p o s = 98 pos=98 p os = 98 p o s = 100 pos=100 p os = 100
只要两者的相对距离都是 k = 2 k=2 k = 2 ;
连接它们两个位置编码的,永远是同一个固定的线性变换矩阵 M k M_k M k !
神经网络最擅长做什么?就是学矩阵乘法(线性变换)!
因为从 p o s pos p os p o s + k pos+k p os + k W Q , W K W_Q, W_K W Q , W K k k k
3. 几何直觉:这其实就是一个「旋转」
学过线性代数的同学可能一眼就看出来了:
那个矩阵 M k M_k M k 2D 旋转矩阵 !
我们把位置编码画在一个圆上:
在位置 p o s pos p os θ 1 = ω ⋅ p o s \theta_1 = \omega \cdot pos θ 1 = ω ⋅ p os
往后走 k k k 旋转了 Δ θ = ω k \Delta\theta = \omega k Δ θ = ω k 。
钟表比喻再次出现:
“往前走 3 个小时”是什么操作?
如果现在是 2 点,往前拨 90 度,到了 5 点。
如果现在是 8 点,往前拨 90 度,到了 11 点。
“距离相隔 3 个小时”这个相对概念,对应在表盘上,永远都只是“顺时针转动 90 度”这一个恒定的旋转动作。
这就是为什么 sin \sin sin cos \cos cos ( sin , cos ) (\sin, \cos) ( sin , cos )
4. 在注意力机制(Attention)中的终极体现:点乘
Transformer 算注意力分数,核心是用词向量算点乘(内积) :Q ⋅ K T Q \cdot K^T Q ⋅ K T
如果模型计算位置 p o s 1 pos_1 p o s 1 p o s 2 pos_2 p o s 2 内积 = sin ( ω ⋅ p o s 1 ) sin ( ω ⋅ p o s 2 ) + cos ( ω ⋅ p o s 1 ) cos ( ω ⋅ p o s 2 ) \text{内积} = \sin(\omega \cdot pos_1)\sin(\omega \cdot pos_2) + \cos(\omega \cdot pos_1)\cos(\omega \cdot pos_2) 内积 = sin ( ω ⋅ p o s 1 ) sin ( ω ⋅ p o s 2 ) + cos ( ω ⋅ p o s 1 ) cos ( ω ⋅ p o s 2 )
利用高中余弦差角公式:cos ( A − B ) = cos A cos B + sin A sin B \cos(A - B) = \cos A \cos B + \sin A \sin B cos ( A − B ) = cos A cos B + sin A sin B 内积 = cos ( ω ( p o s 1 − p o s 2 ) ) \text{内积} = \cos\big(\omega (pos_1 - pos_2)\big) 内积 = cos ( ω ( p o s 1 − p o s 2 ) )
你看!绝对位置 p o s 1 pos_1 p o s 1 p o s 2 pos_2 p o s 2
算出来的相似度只取决于它们的差值 Δ p o s = p o s 1 − p o s 2 \Delta pos = pos_1 - pos_2 Δ p os = p o s 1 − p o s 2
补充:你知道这个思想现在有多火吗?
这个“旋转矩阵表达相对位置”的绝妙思路,后来被苏剑林(Jianlin Su)等人进一步发扬光大,直接做成了现在所有主流大模型(LLaMA 2/3、Mistral、DeepSeek、Qwen 等)标配的:
👉 RoPE(旋转位置编码,Rotary Position Embedding)
RoPE 的本质,就是不再把 ( sin , cos ) (\sin, \cos) ( sin , cos ) 把你的词向量直接乘上上面推导出的那个旋转矩阵 M k M_k M k !
所以,你今天弄懂了成对的 sin / cos \sin/\cos sin / cos
在标准Transformer的设计中,必须保证d_model为偶数。
原因一是因为sin/cos编码需要两两成对。偶数堆为d/2,奇数堆也为d/2
二是任意偶奇相邻通道 ( 2 i , 2 i + 1 ) (2i, 2i+1) ( 2 i , 2 i + 1 ) S O ( 2 ) SO(2) S O ( 2 )
再者,Multi-Head Attention也无法使用奇数的d_model
other why
我们自然而然会想到一个问题,为什么不用1,2,3,4…作为位置信息?
这其实要引出另一个问题:我们的架构需要什么样的位置信息?
我们需要的是「以固定步长计数的绝对位置」,但最终目的是为了让模型能够推导出「相对位置关系」。
因为我们希望我们的编码方式是有界的,不能冲垮神经网络的数值范围。就算归一化到0~1,我们发现10个词的第5个词(0.5)和100个词的第50个词(0.5),意义完全不一样。
See also