Positional Encoding in Transformer
由于Transformer的自注意力机制具有置换不变形(Permutation Invariance)。也就是说即使输入词序列即使被打乱,自注意力的计算结果也完全一致。
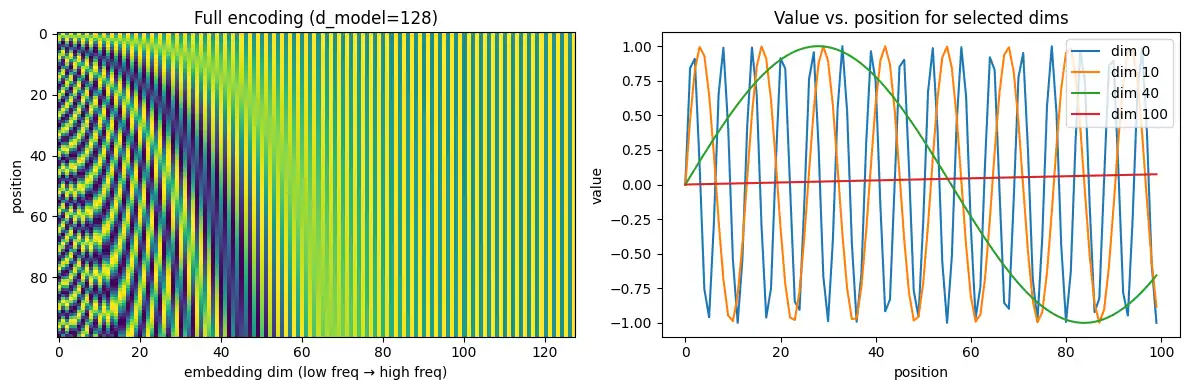
由于Transformer的自注意力机制具有置换不变形(Permutation Invariance)。也就是说即使输入词序列即使被打乱,自注意力的计算结果也完全一致。
仅使用 NumPy 从零开始构建一个用于 MNIST 手写数字识别的神经网络,需要我们剥离现代深度学习框架的高级抽象。在编写哪怕一行代码之前,下文将提供端到端的完整数学推导——从原始灰度像素,到基于微积分的梯度下降。