由于Transformer的自注意力机制具有置换不变形(Permutation Invariance)。也就是说即使输入词序列即使被打乱,自注意力的计算结果也完全一致。
因而我们需要引入位置信息。
Sinusoidal PE
在论文 Vaswani et al. (2017) 中,作者使用了 Sinusoidal Positional ecoding:
我们可以将公式改为更直观的形式:
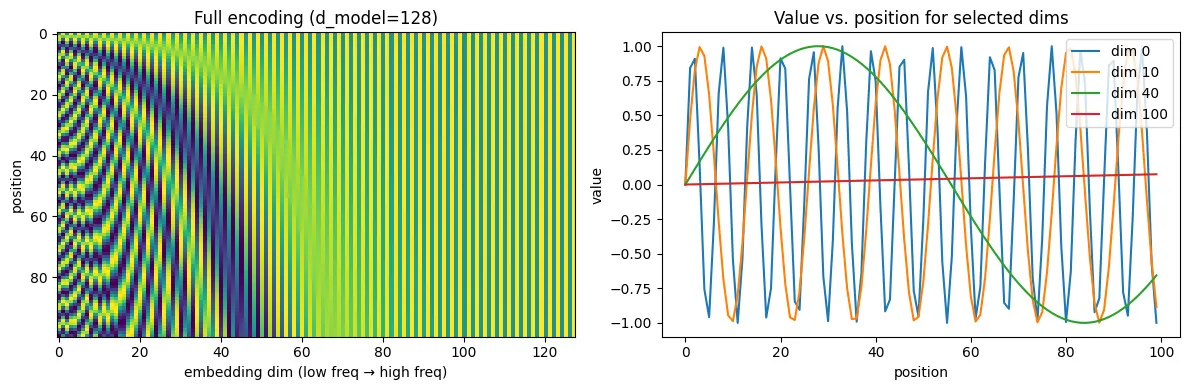
d 是 embedding vector的维度, (Frequency Index)为特征维度的索引,范围是 ,整个 维向量被拆分为 个二维子空间,偶数维放 ,奇数维放 。
随着维度 的增大,呈几何倍地增大, 角频率随之呈几何倍地减小。
在低维度中,, 波长 (约 6.28 个位置就完成一个周期),频率极高,可以捕捉小尺度的局部顺序
在高维度中,, 波长 ,频率极低,可以捕捉全局的长跨度的相对位置
我们有两种直观理解这种现象的方式,一种是在 Deep Learning: Foundations and Concepts 12.1.9 一书中描述的,像是二进制的计数方式,我们不断加1的时候,低位数字变换的频率越往后越慢。也像是时钟,秒针,分针和时针的转完一圈的速度也依次变慢。
相对位置与线性旋转
论文选择正余弦配对,最关键的数学性质在于利用三角恒等式捕获相对距离:对于固定的偏移量 , 可以由 经过一个固定的线性变换矩阵得到。
观察第 组二维子空间 :
写成矩阵形式,即标准的二维旋转矩阵:
这意味着:
- 线性变换矩阵只依赖于相对位移 ,与绝对位置 无关。
- 线性自注意力权重在点积交互时,模型能够非常自然地通过参数矩阵学到相对距离模式(例如“前一个词是什么”或“后五个词是什么”)。
- 几何性质:点积与距离衰减 将两个位置 与 的编码向量直接做内积(点积):
应用和差化积公式,化简为:
这个结果说明了两件事:
- 平移不变性:任意两个位置编码的点积只由它们的相对距离 决定,不依赖于它们在序列中的绝对起始坐标。
- 局部性偏置(Locality):因为不同频率 的余弦波在 时同相相加达到最大值(等于 ),随着相对距离 增大,不同频率的波产生相消干涉,点积值整体迅速衰减。这为自注意力天然引入了“邻近 Token 之间具有更高先验相似度”的归纳偏置。
这种将 2D 旋转矩阵拓展到位置编码的思想,也是后来大型语言模型广泛采用的 RoPE(Rotary Position Embedding) 的直接数学理论前身。
这是其中的代码实现:
import math
import torch
import matplotlib.pyplot as plt

def create_positional_encoding(max_seq_len: int, d_model: int) -> torch.Tensor:
    # (max_seq_len, d_model) buffer filled with zeros
    pe = torch.zeros(max_seq_len, d_model)

    # (max_seq_len, 1) column of positions [0, 1, 2, ..., max_seq_len-1]
    position = torch.arange(0, max_seq_len, dtype=torch.float).unsqueeze(1)

    # (d_model / 2) frequencies: 10000^(-2i/d_model)
    div_term = torch.exp(
        torch.arange(0, d_model, 2).float() * (-math.log(10000.0) / d_model)
    )

    # Even indices (0, 2, 4, ...) -> sin
    pe[:, 0::2] = torch.sin(position * div_term)
    # Odd indices  (1, 3, 5, ...) -> cos
    pe[:, 1::2] = torch.cos(position * div_term)

    return pe  # (max_seq_len, d_model)

pe = create_positional_encoding(max_seq_len=100, d_model=128)

fig, axes = plt.subplots(1, 2, figsize=(12, 4))

# Full heatmap
axes[0].imshow(pe.numpy(), aspect="auto", cmap="viridis")
axes[0].set_title("Full encoding (d_model=128)")
axes[0].set_xlabel("embedding dim (low freq → high freq)")
axes[0].set_ylabel("position")

# A few individual columns, plotted as a curve
for dim in [0, 10, 40, 100]:
    axes[1].plot(pe[:, dim].numpy(), label=f"dim {dim}")
axes[1].set_title("Value vs. position for selected dims")
axes[1].set_xlabel("position")
axes[1].set_ylabel("value")
axes[1].legend()

plt.tight_layout()
plt.show()在标准Transformer的设计中,必须保证d_model为偶数。
原因一是因为sin/cos编码需要两两成对。偶数堆为d/2,奇数堆也为d/2
二是任意偶奇相邻通道 构成一个 2D 平面旋转群 。
再者,Multi-Head Attention也无法使用奇数的d_model